Django:教師あり機械学習を実装してみる「scikit-learn」
 akinori
Django:教師あり機械学習を実装してみる「scikit-learn」
ECサイトのSEOワード評価にAIを使いたい意図があり触り始めたPythonです。
その過程で依頼いただいたサイト作成をDjangoで書いてみたりなどWEB側の操作を多々覚えてきましたが、今回はそもそもの目的の機械学習。
いきなり流入ワードとサジェストを評価させてなんて事はせず、子供の自由研究用データで遊んでみたいと思います。
Pythonの機械学習は【 TensorFlow × Keras 】という深層学習ライブラリの組み合わせが上級者向け【scikit-learn】が初級向けという括りになる様子。機械学習初体験なので今回は迷いなく【scikit-learn】で。
機械学習の入り口に立つために必要なこと
Djangoを利用して機械学習をするにあたり、最低限必要なことが2つあります。
- Pandasを(調べながらでも)それなり操作できること
- PresetClassを利用せず、View関数の作成にてサイト構築ができること
def~~でVeiwを書いていれば嫌でもpandasを扱っていると思うので、そういう方には機械学習の初手はとても簡単です。
まずは決定木を作るところまでを目的としてみる
本来的には決定木を作成するまでに様々なデータ処理が必要なのだそうです。
- クリーンニング(外れ値を除外する ※外れ値:大きなまとまりの外にポツンと存在する例外。中央値と平均を遠ざける値)
- 特徴量の選択(特徴量:分析すべきデータや対象物の特徴・特性を、定量的に表した数値)
- 欠損値の処理(欠損値:特徴量のデータがそろっていないレコード。破棄したり平均値で穴埋め処理する)
- 過学習対策(過学習:訓練誤差は小さいにもかかわらず、汎化誤差が小さくならない状態 ※汎化誤差=未知のデータを判定したときの誤差)
- データ次元削除(次元の呪いを回避するための処理。※次元の呪い:データの次元数が大きくなり過ぎると組み合わせが飛躍的に多くなり、有限なサンプルデータでは十分な学習結果が得られなくなる)
- クラスタリング(特徴の似たものをグループ化していくこと)
今回は機械学習構築の初体験なので、これらデータの前処理は飛ばします。まず体験してみようというやつです。
なので、作成した決定木に意味は求めません。
あくまでも『決定木を作ること』を目的として実装/実行していきます。
必要な道具を用意する(事前準備)
事前準備は3つ。このうちの1は決定木を作成するライブラリ。2~3は決定木を見るためのツールです。
- scikit-learnライブラリのインストール
- Graphvizのインストール(自分のPCへインストール)
- C:\Program Files\Graphviz\binへパスを通す ※インストール時にチェックを忘れた場合はシステム設定から追加操作
scikit-learnのインストール
# pipでインストールする場合
pip install scikit-learn

# anacondaでインストールする場合
conda install scikit-learn
Dockerの場合はコンテナビルド後の手間を減らすための requirements.txt への追加を忘れないように。
サーバー側の準備はこれだけでOKです。
Graphvizのインストール
Djangoをベースとして機械学習を行う場合、決定木のビジュアライズに難点があります。
scikit-learnの【tree.plot_tree】ではPython上では見えてもDjangoのTemplateへビジュアライズされた決定木を表示してくれません。そこら辺はおいおい詰めていく記事を書いていきたいと思いますが、今回は下の流れで決定木をビジュアライズします。
- tree.export_graphviz(model, feature_names = columns, out_file='tree.dot') で 決定木モデルをDOTデータに変換
- FTP(SFTP)経由でDATデータをデスクトップに移動
- コマンドツールにて dot -Tpng tree.dot -o tree.png を実行。※Graphivizで決定木をPNG画像化
決定木ってなに?
ここまで何度もワードが出てきていますが、決定木とは『与えられた事象を分析するルート』の事です。教師アリ機械学習では、条件と答えを与えることで「どんな条件の時にどうなるか」を機械が分類し決定木を作成してくれます。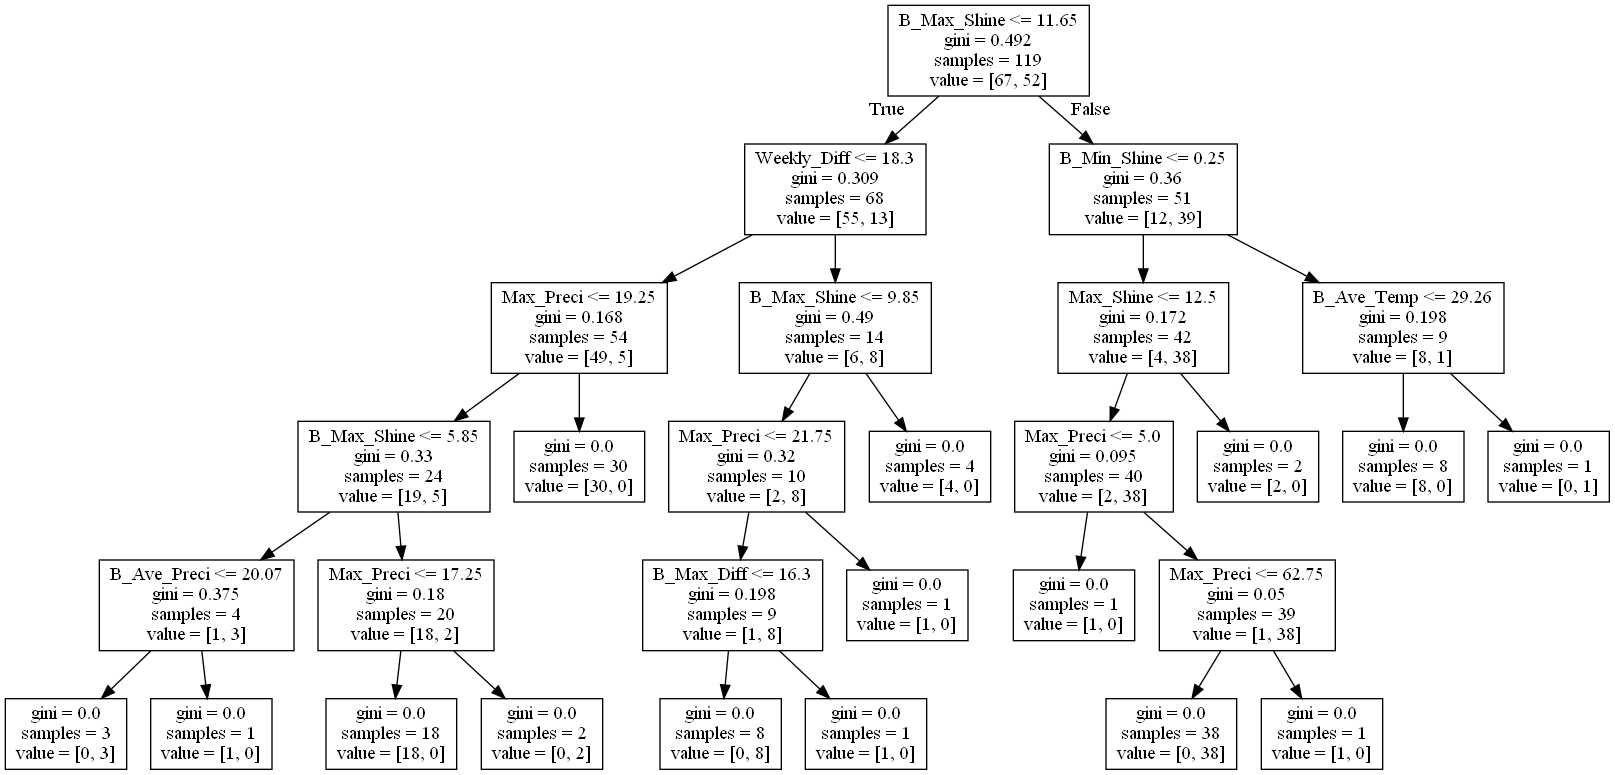
※左:娘の自由研究のデータ(四つ葉のクローバーが出来た週の気象データとできなかった時の気象データ)を学習させた結果。気象データを『特徴量』四つ葉が出来たか否かを『正解ラベル』として渡して作成してみた決定木。
scikit-learnにデータを解析してもらう手順
- views.pyに from sklearn import tree を加える
- 『特徴量』と『正解ラベル(答え)』をDataFrame型で用意する
- 未学習のモデルを用意する model = tree.DecisionTreeClassifier(max_depth = 5, random_state = 0)
- モデルに『特徴量』と『正解ラベル』を与えて学習実行 model.fit( 特徴量, 正解ラベル )
学習自体はこれだけで完了です。
なんて簡単な...。
実際に書いたスクリプト
#clover\views.py
import logging
from datetime import datetime, date, timedelta
import pandas as pd
from .models import Weekly_quantity, Weather
from django.db.models import Q, Sum, Max, Min, Avg
from sklearn import tree

""" 機械学習勉強用_学習/出力パーツ """
def CloverAIFerView(request):

    AI_Data = GrowLeafWeeklyData()
    DT = AI_Data[0]# 特徴量
    AN = AI_Data[1]# 正解ラベル
    columns = AI_Data[2]# カラム名
    pd.set_option('display.max_rows', 1000)

    # 未学習モデルの作成
    model = tree.DecisionTreeClassifier(max_depth = 10, random_state = 0)
    # 学習の実行
    model.fit(DT, AN)

    # python上で確認できる[scrikit-learn] の機能を使った決定木プロット ※このままではDjangoでビジュアライズされない
    Tree = tree.plot_tree(model, feature_names = columns, filled = True)

    # 決定木モデルをDOTデータに変換
    tree.export_graphviz(model, feature_names = columns, out_file='clover/tree.dot')

    params = {
        'ai_data': Tree
    }
    return render(request, 'clover/sk_learn.html', params)


""" 機械学習用_データ生成パーツ """
def GrowLeafWeeklyData():
    # 四つ葉が出来た週を抽出する ※先週より増加した週
    day_data = GrowDate()

    #変化のあった週の日付で気象庁データを抽出
    Grows_Wether = []
    for p_day in day_data[0]:
        #週間MAXとMINを取得
        oneDayBefore = Search_Range_Temperatures(p_day[0], p_day[1], p_day[2], p_day[3])
        oneWeekBefore = Search_Range_Temperatures(p_day[4], p_day[5], p_day[2], p_day[3])
        #タプル合成
        WeekData = oneDayBefore + oneWeekBefore
        if WeekData[2]:
            Grows_Wether.append(WeekData)

    #四つ葉の増加がなかった気象データを抽出
    None_Wether = []
    for p_day in day_data[1]:
        oneDayBefore = Search_Range_Temperatures(p_day[0], p_day[1], p_day[2], p_day[3])
        oneWeekBefore = Search_Range_Temperatures(p_day[4], p_day[5], p_day[2], p_day[3])

        #タプル合成
        WeekData = oneDayBefore + oneWeekBefore
        if WeekData[2]:
            None_Wether.append(WeekData)

    #四葉のカウントがゼロ以下の時
    picker = Weekly_quantity.objects.filter(Q(four_leafs__lt=1)).order_by('start_date')
    for p in picker:
        oneDayBefore = Search_Range_Temperatures(p.start_date - timedelta(days=1), p.end_date - timedelta(days=1), 0, 0)
        oneWeekBefore = Search_Range_Temperatures(p.start_date - timedelta(days=8), p.end_date - timedelta(days=8), 0, 0)

        #タプル合成
        WeekData = oneDayBefore + oneWeekBefore
        if WeekData[2]:
            None_Wether.append(WeekData)

    # 全部乗せバージョン
    Grows = WeeklyDataChangeDataFrame_AllIn(Grows_Wether)
    Nones = WeeklyDataChangeDataFrame_AllIn(None_Wether)

    # データと答えに分ける ※ ignore_index=Trueでインデックス振り直し
    Colect = pd.concat([Grows[0],Nones[0]], ignore_index=True)
    Answer = pd.concat([Grows[1],Nones[1]], ignore_index=True)
    column = Nones[2]

    return Colect, Answer, column
def WeeklyDataChangeDataFrame_AllIn(data):
    # GrowLeafWeeklyData内で生成したタプルデータをリストに格納しデータフレームに変換する
    list = []
    Ans = []
    for d in data:
        if d[13] >= 1:
            list.append([
                 d[2], d[3], d[4], d[5], d[6], d[7], d[8], d[9], d[10], d[11], d[12],
                 d[17], d[18], d[19], d[20], d[21], d[22], d[23], d[24], d[25], d[26], d[27]
            ])
            Ans.append([1])
        else:
            list.append([
                d[2], d[3], d[4], d[5], d[6], d[7], d[8], d[9], d[10], d[11], d[12],
                d[17], d[18], d[19], d[20], d[21], d[22], d[23], d[24], d[25], d[26], d[27]
            ])
            Ans.append([0])

    # カラム名を用意する ※ビジュアライズの際に日本語が使えない為、日本語表記はやめる。
    column = [
        "Max_Temp", "Min_Temp","Max_Diff","Ave_Temp", "Max_Shine","Min_Shine","Ave_Shine", "Max_Preci","Min_Preci","Ave_Preci","Weekly_Diff",
        "B_Max_Temp", "B_Min_Temp","B_Max_Diff","B_Ave_Temp","B_Max_Shine","B_Min_Shine","B_Ave_Shine","B_Max_Preci","B_Min_Preci","B_Ave_Preci","B_Weekly_Diff"
    ]
    # リストを DataFrameに変換
    df_list = pd.DataFrame(list, columns=column)
    df_ans = pd.DataFrame(Ans, columns=["Ans"])

    return df_list, df_ans, column

””” 基礎的集計 """
def GrowDate():
    #四つ葉が出来た週を抽出する ※先週より増加した週
    picker = Weekly_quantity.objects.filter(Q(four_leaves__gte=1)).order_by('start_date')
    NonGrowDays = []
    GrowUpDays = []

    for p in picker:
        start = (p.start_date - timedelta(days=7))
        end = (p.end_date - timedelta(days=7))
        sample = Weekly_quantity.objects.filter(start_date__range=[start, end]).reverse()[:1]
        b_data = [
                p.start_date - timedelta(days=1),
                p.end_date - timedelta(days=1),
                p.four_leaf - sample[0].four_leaf,
                p.five_leaf - sample[0].five_leaf,
                p.start_date - timedelta(days=8),
                p.end_date - timedelta(days=8)]

        if p.four_leaf > sample[0].four_leaf:
            GrowUpDays.append(b_data)
        else:
            #四葉の数が1以上で先週より増加の無いもの
            NonGrowDays.append(b_data)
    return GrowUpDays, NonGrowDays
def Search_Range_Temperatures(start,end,fourleaf,fifthleaf):
    #気象データ抽出※期間はクローバー観察データと同期
    picker_02 = Weather.objects.filter(observation_date__range=[start, end])\
        .order_by('observation_date')
    if picker_02:
        #気温差の最大と日照時間の最大値などを取得
        Max_Temp = picker_02.aggregate(Max('max_temperature'))['max_temperature__max']# 週間最高気温
        Min_Temp = picker_02.aggregate(Min('min_temperature'))['min_temperature__min']# 週間最低気温
        Max_Diff = picker_02.aggregate(Max('diff_temp'))['diff_temp__max']# 1日の最大気温差
        Ave_Temp = round(picker_02.aggregate(Avg('temperature'))['temperature__avg'], 2)# 週間平均気温
        Max_Shine = picker_02.aggregate(Max('daylight_hours'))['daylight_hours__max']# 週間最高日照時間
        Min_Shine = picker_02.aggregate(Min('daylight_hours'))['daylight_hours__min']# 週間最低日照時間
        Ave_Shine = round(picker_02.aggregate(Avg('daylight_hours'))['daylight_hours__avg'], 2)# 週間平均日照時間
        Max_Preci = picker_02.aggregate(Max('precipitation'))['precipitation__max']# 週間最大降水量
        Min_Preci = picker_02.aggregate(Min('precipitation'))['precipitation__min']# 週間最低降水量
        Ave_Preci = round(picker_02.aggregate(Avg('precipitation'))['precipitation__avg'], 2)# 週間平均日照時間
        Weekly_Diff = round(Max_Temp-Min_Temp, 2)# 週間気温差
        return start, end, Max_Temp, Min_Temp, Max_Diff, Ave_Temp, Max_Shine, Min_Shine, Ave_Shine, Max_Preci, Min_Preci, Ave_Preci, Weekly_Diff, fourleaf, fifthleaf
    else:
        return start,end,None,None,None,None,None,None,None,None,None,None,None,0,0
こんな感じで、機械学習に掛けるパーツより、データを成形するパーツの方がスクリプトは多くなります。
なので、Pandasやテーブルの扱いが機械学習の実装が出来るか否かの分岐点になると思います。
DOTデータのできる場所はどこか
上のScriptの27行目がDOT出力のパーツです。
最初 out_file='tree.dot' としていたのですが、データが生成された気配がなく困っていました。
- out_file='tree.dot' :どこにも見当たらない。
- out_file='app/tree.dot' :プロジェクト\アプリのディレクトリに保存される。
理屈上はプロジェクトの直下に生成されそうなのですが、できませんでした。
誰のデータか判断するためにも、アプリ/views.pyで出力指示をしていてもアプリディレクトリから記載するようにしましょう。
決定木のビジュアライズ
ここからはPC上での操作になります。
私のPCはWindowsなのでWIN10での操作です。
Graphvizをインストールする
こちらから自分のPCに最適なものを選びダウンロードします。
Graphvizを利用するためにはパスを通す必要があります。
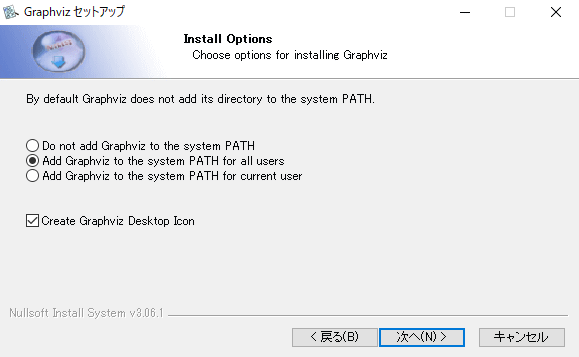
インストール時の画面にてAdd~~PATHの箇所にチェックを入れるとシステム詳細設定を弄る必要なくパス追加まで自動で処理してくれふので、忘れずにチェックしましょう。
tree.dotファイルをダウンロードする
わかりやすくデスクトップに置いてみます。
コマンドプロントを開きtree.dotを保存したフォルダに移動
コマンドプロントを立ち上げるとUSERに移動しているのでデスクトップに移動します。
cd Desktop
決定木をビジュアライズした画像データ生成
dot -Tpng tree.dot -o tree.png
コマンドプロントでこれを打つだけです。
これでtree.pngという画像がデスクトップ上に生成されます。
まとめ
上のコードだけで、作成した決定木モデルに対して下のように指示すると四つ葉が出来るかを推定してくれます。
test = [[ 評価する特徴量データ ]]
Expected = model.predict(test)
ただ、「さぁ、正解率は」となるとデータに前処理をしていないので、よろしくありません。
結局、入れた特徴量が結論に対して分散していると推測に誤が多くなるって事ですかね。
なので、機械学習自体は簡単に実装できるけど【どのデータで分析するか】の特徴量の選定が重要になってくるのだろうと思います。
※与えられたデータを登録することで、特徴量と正解ラベルの相関関係の特徴をつかむことは十分にできます。
面白い!しばらくこれで遊べそうです。
\ 最新情報をチェック /